Spider Cloud
Scrapowanie i przechodzenie serwisów rozliczane za gigabajt. Nieudane zapytania kosztują zero.
Tagi
Szczegóły
-
Kategoria
- IT
-
Platforma
-
Web
-
Cena od
-
0 $
-
Open source
-
Tak
-
Polskie menu
-
Nie
-
API
-
Tak

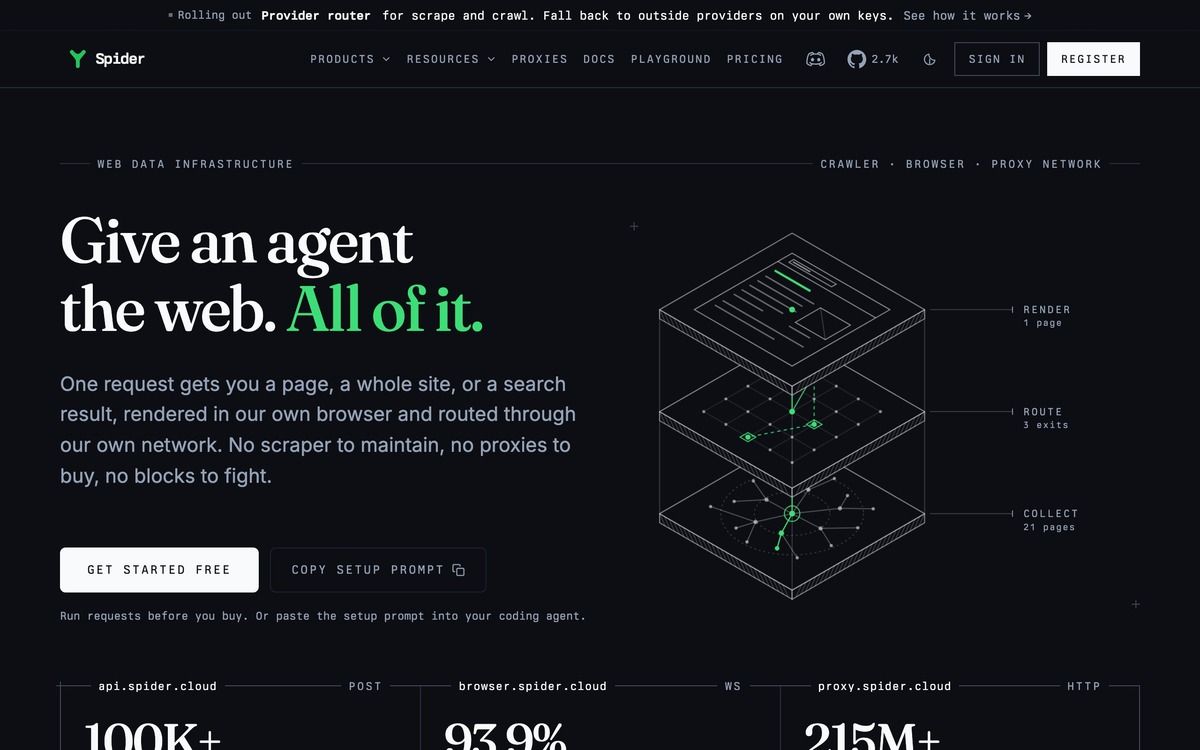
Spider Cloud pobiera strony i przechodzi po całych serwisach, zwracając treść gotową do podania modelowi językowemu. Rozliczenie idzie za przesłane dane: od 1 USD za gigabajt w modelu doładowań, a zapytania zakończone błędem nic nie kosztują. Jest też plan stały za 350 USD miesięcznie z gwarantowaną liczbą równoległych zapytań. Typowe zastosowanie: zebranie treści z serwisu konkurencji albo zasilenie bazy wiedzy zawartością stron.
Jaki problem rozwiązuje Spider Cloud?
Zebranie treści z całego serwisu pod bazę wiedzy albo analizę konkurencji kończy się zwykle własnym skryptem, który działa przez tydzień, a potem zaczyna dostawać blokady i gubić strony renderowane JavaScriptem. Spider Cloud przejmuje przechodzenie po serwisie i zwraca treść w postaci gotowej do podania modelowi językowemu, rozliczając wyłącznie faktycznie przesłane dane.
Kluczowe możliwości Spider Cloud
Przechodzenie całych serwisów — podajesz adres startowy, dostajesz treść wszystkich podstron bez pisania własnej kolejki.
Treść gotowa dla modelu — wynik przychodzi jako czysty tekst albo Markdown, bez menu i skryptów.
Rozliczenie za gigabajt — od 1 USD za GB, a zapytania zakończone błędem kosztują zero.
Obsługa stron renderowanych skryptami — treść pojawiająca się dopiero po wykonaniu JavaScriptu też jest pobierana.
Dwa modele opłat — doładowania od 5 USD albo stały plan za 350 USD miesięcznie z gwarantowaną liczbą równoległych zapytań.
Dla kogo jest Spider Cloud?
Dla zespołów budujących bazę wiedzy z treści stron. Dla analityków zbierających materiał z serwisów konkurencji do porównania. Dla twórców agentów AI, którzy potrzebują aktualnej treści stron, a nie tego, co model zapamiętał podczas treningu.
Czym wyróżnia się Spider Cloud?
Sposobem naliczania opłat. Konkurencja liczy za zapytanie albo za stronę, więc nieudane próby też kosztują, a przy dużych serwisach rachunek trudno przewidzieć przed startem. Tutaj płacisz za przesłane dane, a błędy są darmowe, więc koszt przechodzenia serwisu da się oszacować z jego rozmiaru. Silnik jest napisany w Rust i dostępny jako projekt otwarty, więc część pracy uruchomisz u siebie.
Podobne narzędzia
Zobacz wszystkie narzędzia
Advertools
Biblioteka Pythona dla marketerów: crawler SEO, analiza robots.txt i map witryn, słowa kluczowe do kampanii.
Aider
Programujesz w parze z modelem w terminalu. Sam commituje zmiany do gita.

Scrapy
Najpopularniejszy otwarty framework do pobierania danych ze stron. Asynchroniczny i rozszerzalny wtyczkami.
Brave Search API
Wyniki z własnego indeksu Brave, nie z cudzego. Osobny tryb przygotowany pod modele językowe.
Cohere
Modele do generowania tekstu, embeddingów i rerankingu wyników wyszukiwania. Mocne w wielu językach.
Cursor
Oszczędź godziny przy refaktorach i debugowaniu dzięki AI, która rozumie cały Twój projekt.